精细化 CPU 编排
摘要
该提案详细定义了 Koordinator QoS 的细粒度 CPU 编排,以及如何兼容 K8s 现有的设计原则和实现, 描述了 koordlet、koord-runtime-proxy 和 koord-scheduler 需要增强的功能。
动机
越来越多的系统利用 CPU 和硬件加速器的组合来支持延迟关键性的执行和高吞吐量并行计算。其中包括电信、科学计算、机器学习、金融服务和数据分析等领域的工作负载。这种混合系统构成高性能环境。
为了获得最佳性能,需要实现 CPU 隔离、NUMA-locality 相关的优化。
目标
- 改进 Koordinator QoS 的 CPU 编排定义。
- 明确兼容 kubelet CPU Manager Policy的策略。
- 阐明 koordlet 应如何增强 CPU 调度机制。
- 为应用和集群管理员提供一套 API 支持复杂的CPU编排场景,例如 CPU 绑定策略、CPU 独占策略、NUMA 拓扑对齐策略和NUMA 拓扑信息等
- 提供优化 CPU 编排的 API。
非目标/未来工作
- 描述 koordlet/koordlet-runtime-proxy 的具体设计细节。
- 描述 CPU 重调度机制的具体设计细节。
设计概述

当 koordlet 启动时,koordlet 从 kubelet 收集 NUMA 拓扑信息,包括 NUMA 拓扑、CPU 拓扑、kubelet CPU 管理策略、kubelet 为 Guaranteed Pod 分配的 CPU 等,并更新到节点资源拓扑 CRD。当延迟敏感的应用程序扩容时,可以为新Pod设置 Koordinator QoS LSE/LSR、CPU绑定策略和 CPU独占策略,要求 koord-scheduler 分配最适合的 CPU 以获得最佳性能。当 koord-scheduler 调度 Pod 时,koord-scheduler 会过滤满足 NUMA 拓扑对齐策略的节点,并通过评分选择最佳节点,在 Reserve 阶段分配 CPU,并在 PreBinding 时将结果记录到 Pod Annotation。koordlet 通过 Hook kubelet CRI 请求,替换通过 koord-scheduler 调度的 CPU 配置参数到运行时,例如配置 cgroup。
用户故事
故事 1
兼容 kubelet 现有的 CPU 管理策略。CPU 管理器 static 策略允许具有某些资源特征的 Pod 在节点中被授予更高的 CPU 亲和性和排他性。如果启用 static 策略,集群管理员必须配置 kubelet 保留一些 CPU。 static 策略有一些选项,如果指定了 full-pcpus-only(beta, 默认可见) 策略选项,则 static 策略将始终分配完整的物理内核。如果指定了 distribute-cpus-across-numa(alpha, 默认不可见) 选项,在需要多个 NUMA 节点来满足分配的情况下, static 策略将在 NUMA 节点之间平均分配 CPU。
故事 2
同样,应该兼容社区中现有的 K8s Guaranteed Pod 的语义。静态策略分配给 K8s Guaranteed Pod 的 CPU 不会共享给默认的 BestEffort Pod,所以相当于 LSE。但是当节点的负载比较低时,LSR Pod 分配的 CPU 应该与 BestEffort 的工作负载共享,以获得经济效益。
故事 3
拓扑管理器是一个 kubelet 组件,旨在协调负责这些优化的组件集。引入拓扑管理器后,在工作节点具有不同的 NUMA 拓扑,并且该拓扑中具有不同资源量的集群中启动 Pod 的问题成为现实。Pod 可以调度在资源总量足够的节点上,但是资源分布不能满足合适的拓扑策略。
故事 4
调度器支持协调编排多个延迟敏感的应用程序。例如,支持延迟敏感的应用程序多个实例在 CPU 维度上互斥,并且延迟敏感的应用和一般应用在 CPU 维度亲和。这样可以降低成本并保证运行质量。
故事 5
在基于 NUMA 拓扑分配 CPU 时,用户希望有不同的分配策略。例如 bin-packing 优先,或者分配最空闲的 NUMA 节点。
故事 6
随着应用程序的伸缩或滚动,最适合的可分配空间会逐渐变得碎片化,这会导致一些策略的分配效果不好,影响应用程序的运行时效果。
设计细节
CPU 编排基本原则
- 仅支持 Pod 维度的 CPU 分配机制。
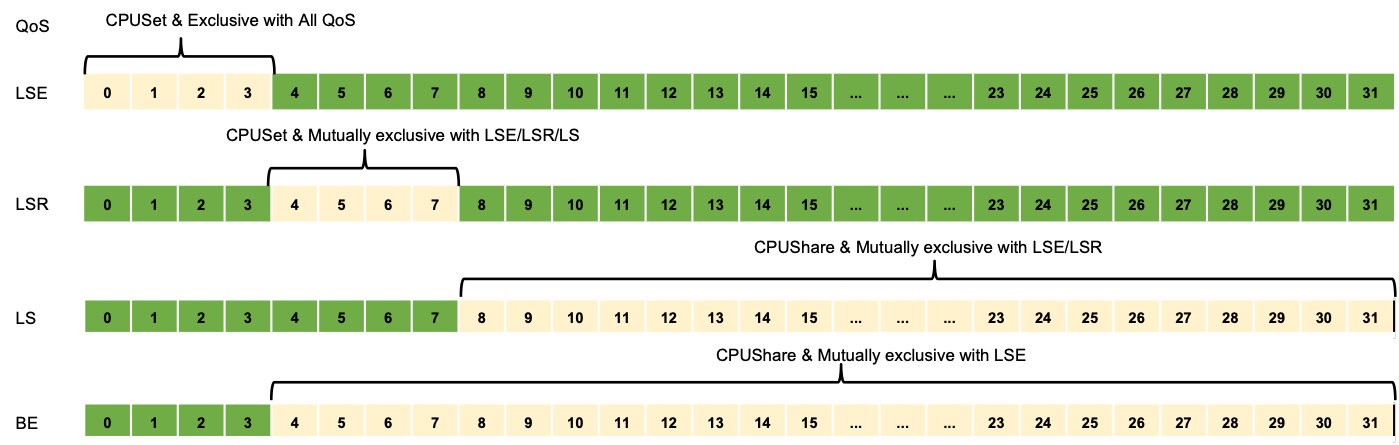
- Koordinator 将机器上的 CPU 分为
CPU Shared Pool,statically exclusive CPUs和BE CPU Shared Pool。CPU Shared Pool是一组共享 CPU 池,K8s Burstable 和 Koordinator LS Pod 中的任何容器都可以在其上运行。K8s Guaranteedfractional CPU requests的 Pod 也可以运行在CPU Shared Pool中。CPU Shared Pool包含节点中所有未分配的 CPU,但不包括由 K8s Guaranteed、LSE 和 LSR Pod 分配的 CPU。如果 kubelet 保留 CPU,则CPU Shared Pool包括保留的 CPU。statically exclusive CPUs是指分配给 K8s Guaranteed、Koordinator LSE/LSR Pods 使用的一组独占 CPU。当 K8s Guaranteed、LSE 和 LSR Pods 谁申请 CPU 时,koord-scheduler 将从CPU Shared Pool中分配。BE CPU Shared pool是一组K8s BestEffort和Koordinator BE的 Pod 都可运行的 CPU 池。BE CPU Shared pool包含节点中除 K8s Guaranteed 和 Koordinator LSE Pod 分配的之外的所有 CPU。
Koordinator QoS CPU 编排原则
- LSE/LSR Pod 的 Request 和 Limit 必须相等,CPU 值必须是 1000 的整数倍。
- LSE Pod 分配的 CPU 是完全独占的,不得共享。如果节点是超线程架构,只保证逻辑核心维度是隔离的,但是可以通过
CPUBindPolicyFullPCPUs策略获得更好的隔离。 - LSR Pod 分配的 CPU 只能与 BE Pod 共享。
- LS Pod 绑定了与 LSE/LSR Pod 独占之外的共享 CPU 池。
- BE Pod 绑定使用节点中除 LSE Pod 独占之外的所有 CPU 。
- 如果 kubelet 的 CPU 管理器策略为 static 策略,则已经运行的 K8s Guaranteed Pods 等价于 Koordinator LSR。
- 如果 kubelet 的 CPU 管理器策略为 none 策略,则已经运行的 K8s Guaranteed Pods 等价于 Koordinator LS。
- 新创建但未指定 Koordinator QoS 的 K8s Guaranteed Pod 等价于 Koordinator LS。
kubelet CPU Manager Policy 兼容原则
- 如果 kubelet 设置 CPU 管理器策略选项
full-pcpus-only=true/distribute-cpus-across-numa=true,并且节点中没有 Koordinator 定义的新 CPU 绑定策略,则遵循 kubelet 定义的这些参数的定义。 - 如果 kubelet 设置了拓扑管理器策略,并且节点中没有 Koordinator 定义的新的 NUMA Topology Alignment 策略,则遵循 kubelet 定义的这些参数的定义。
接管 kubelet CPU 管理的阶段
先前由 kubelet 静态 CPU 管理器管理的节点可以由 Koordinator 接管,以下步骤是:
- 当用户希望保持 kubelet 静态 CPU 管理器在节点离线或删除之前使用,他们可以设置 koordlet 的参数
disable-query-kubelet-config=true和 feature-gateCPUSetAllocator=false。它将禁用报告 kubelet cpu 管理器状态和 koordlet 的 cpuset cgroups 管理,从而让 koord-scheduler 忽略 kubelet 管理的绑核 cpus。通过这些配置,调度程序可以分配包含 kubelet 静态 CPU 管理器管理的 CPU 的绑核 cpus。并且容器 cgroups 绑核仍然由 kubelet 控制。当节点离线或准备进入第 2 阶段时,用户可以重置disable-query-kubelet-config=false和启用 feature-gateCPUSetAllocator=false。 - 默认情况下,koordlet 应该接管新 pod 的绑核 cpus。已由 kubelet 静态 CPU 管理器控制的存量绑核 pods 信息将根据
/configz和cpu_manager_state上报,以便于调度器在 CPU 分配时排除这些 cpus。对于新调度的绑核 pods,koordlet 将遵循这些 pods 在 annotations 上的绑核结果,它们排除了由 kubelet 静态 CPU 管理器控制的绑核 cpus。用户应该不再使用 kubelet 静态 CPU 管理器, 并设置策略为 "none"。当最后一个 kubelet 静态 CPU 管理器管理的 pods 终止时,koordlet 将完全接管这些 cpus。
接管 kubelet CPU 管理策略
kubelet 预留的 CPU 主要服务于 K8s BestEffort 和 Burstable Pods。但 Koordinator 不会遵守该策略。K8s Burstable Pods 应该使用 CPU Shared Pool,而 K8s BestEffort Pods 应该使用 BE CPU Shared Pool。Koordinator LSE 和 LSR Pod 不会从被 kubelet 预留的 CPU 中分配。
- 对于 K8s Burstable 和 Koordinator LS Pod:
- 当 koordlet 启动时,计算
CPU Shared Pool并将共享池应用到节点中的所有 Burstable 和 LS Pod,即更新它们的 cpu cgroups, 设置 cpuset。在创建或销毁 LSE/LSR Pod 时执行相同的逻辑。 - koordlet 会忽略 kubelet 预留的 CPU,将其替换为 Koordinator 定义的
CPU Shared Pool。
- 当 koordlet 启动时,计算
- 对于 K8s BestEffort 和 Koordinator BE Pod:
- 如果 kubelet 预留了 CPU,BestEffort Pod 会首先使用预留的 CPU。
- koordlet 可以使用节点中的所有 CPU,但不包括由具有整数 CPU 的 K8s Guaranteed 和 Koordinator LSE Pod 分配的 CPU。这意味着如果 koordlet 启用 CPU Suppress 功能,则应遵循约束以保证不会影响 LSE Pod。同样,如果 kubelet 启用了静态 CPU 管理器策略,则也应排除 K8s Guaranteed Pod。
- 对于 K8s Guaranteed Pod:
- 如果 Pod 的 annotations 中有 koord-scheduler 更新的
scheduling.koordinator.sh/resource-status,在 Sandbox/Container 创建阶段,则会替换 kubelet CRI 请求中的 CPUSet。 - kubelet 有时会调用 CRI 中定义的 Update 方法来更新容器 cgroup 以设置新的 CPU,因此 koordlet 和 koord-runtime-proxy 需要 Hook 该方法。
- 如果 Pod 的 annotations 中有 koord-scheduler 更新的
- 自动调整
CPU Shared Pool大小- koordlet 会根据 Pod 创建/销毁等变化自动调整
CPU Shared Pool的大小。如果CPU Shared Pool发生变化,koordlet 应该更新所有使用共享池的 LS/K8s Burstable Pod 的 cgroups。 - 如果 Pod 的 annotations
scheduling.koordinator.sh/resource-status中指定了对应的CPU Shared Pool,koordlet 在配置 cgroup 时只需要绑定对应共享池的 CPU 即可。
- koordlet 会根据 Pod 创建/销毁等变化自动调整
接管逻辑要求 koord-runtime-proxy 添加新的扩展点并且 koordlet 实现新的运行时插件的 Hook 。当没有安装 koord-runtime-proxy 时,这些接管逻辑也将能够实现。
CPU 编排 API
应用程序 CPU 编排 API
Resource Spec
Annotation scheduling.koordinator.sh/resource-spec 是 Koordinator 定义的资源分配 API。用户通过设置 annotation 来指定所需的 CPU 编排策略。未来,我们还可以根据需要扩展和添加需要支持的资源类型。Annotation Value 对应的定义如下:
// ResourceSpec describes extra attributes of the compute resource requirements.
type ResourceSpec struct {
  PreferredCPUBindPolicy       CPUBindPolicy      `json:"preferredCPUBindPolicy,omitempty"`
  PreferredCPUExclusivePolicy  CPUExclusivePolicy `json:"preferredCPUExclusivePolicy,omitempty"`
}

type CPUBindPolicy string

const (
  // CPUBindPolicyDefault performs the default bind policy that specified in koord-scheduler configuration
  CPUBindPolicyDefault CPUBindPolicy = "Default"
  // CPUBindPolicyFullPCPUs favor cpuset allocation that pack in few physical cores
  CPUBindPolicyFullPCPUs CPUBindPolicy = "FullPCPUs"
  // CPUBindPolicySpreadByPCPUs favor cpuset allocation that evenly allocate logical cpus across physical cores
  CPUBindPolicySpreadByPCPUs CPUBindPolicy = "SpreadByPCPUs"
  // CPUBindPolicyConstrainedBurst constrains the CPU Shared Pool range of the Burstable Pod
  CPUBindPolicyConstrainedBurst CPUBindPolicy = "ConstrainedBurst"
)

type CPUExclusivePolicy string

const (
  // CPUExclusivePolicyDefault performs the default exclusive policy that specified in koord-scheduler configuration
  CPUExclusivePolicyDefault CPUExclusivePolicy = "Default"
  // CPUExclusivePolicyPCPULevel represents mutual exclusion in the physical core dimension
  CPUExclusivePolicyPCPULevel CPUExclusivePolicy = "PCPULevel"
  // CPUExclusivePolicyNUMANodeLevel indicates mutual exclusion in the NUMA topology dimension
  CPUExclusivePolicyNUMANodeLevel CPUExclusivePolicy = "NUMANodeLevel"
)
CPUBindPolicy定义CPU绑定策略。具体取值定义如下:CPUBindPolicyDefault或空值不执行任何绑定策略。它完全由调度器插件配置决定。CPUBindPolicyFullPCPUs是一种 bin-packing 策略,类似于 kubelet 定义的full-pcpus-only=true选项,用于分配完整的物理内核。但是,如果节点中剩余的逻辑 CPU 数量足够,但完整的物理核心数量不足,则继续分配。该策略可以有效避免扰邻(noisy neighbor)问题。CPUBindPolicySpreadByPCPUs是一种打散(Spread)策略。如果节点启用了超线程,当采用该策略时,调度器将在物理内核之间均匀的分配逻辑 CPU。例如,当前节点有 8 个物理内核和 16 个逻辑 CPU。当一个 Pod 需要 8 个逻辑 CPU 并且采用CPUBindPolicySpreadByPCPUs策略时,调度器会从每个物理核中分配一个逻辑 CPU。该策略主要用于一些具有多种不同峰谷特性的延迟敏感型应用程序。它不仅可以让应用程序在特定时间充分使用 CPU,而且不会被同一物理内核上的应用程序所干扰。所以在使用这个策略时可能会出现扰邻(noisy neighbor)问题。CPUBindPolicyConstrainedBurst主要帮助 K8s Burstable/Koordinator LS Pod 获得更好性能的特殊策略。使用该策略时,koord-scheduler 会根据 Pod 限制过滤掉具有合适 CPU 共享池的 NUMA 节点的节点。调度成功后,调度器会更新 Pod 中的scheduling.koordinator.sh/resource-status,声明要绑定的CPU Shared Pool。koordlet 根据CPU Shared Pool绑定对应 NUMA Node 的CPU Shared Pool。- 如果
NodeResourceTopology中的kubelet.koartiator.sh/cpu-manager-policy选项为full-pcpus-only=true,或者 Node 中的node.koordator.sh/cpubind-policy的值为FullPCPUsOnly,则 koord-scheduler 会检查实例的 CPU 请求数是否满足 SMT 对齐要求,以避免调度后被 kubelet 拒绝。如果 Pod 使用CPUBindPolicySpreadByPCPUs策略或映射到物理核心数的逻辑 CPU 数量不是整数,koord-scheduler 将避免调度此类节点。
CPUExclusivePolicy定义了 CPU 独占策略,它可以帮助解决扰邻(noisy neighbor)问题。具体值定义如下CPUExclusivePolicyDefault或空值不执行任何隔离策略。它完全由调度器插件配置决定。CPUExclusivePolicyPCPULevel在分配逻辑CPU时,尽量避开已经被同一个独占策略申请的物理核。它是对CPUBindPolicySpreadByPCPUs策略的补充。CPUExclusivePolicyNUMANodeLevel在分配逻辑 CPU 时,尽量避免 NUMA 节点已经被相同的独占策略申请。如果没有满足策略的 NUMA 节点,则降级为CPUExclusivePolicyPCPULevel策略。
对于ARM架构,CPUBindPolicy 只支持 CPUBindPolicyFullPCPUs ,CPUExclusivePolicy 只支持 CPUExclusivePolicyNUMANodeLevel 。
Resource Status
Annotation scheduling.koordinator.sh/resource-status 表示资源分配结果。 koord-scheduler 在绑定 Pod 到节点之前修改 annotation。 koordlet 使用结果来配置 cgroup。
Annotation value 对应的定义如下:
type ResourceStatus struct {
  CPUSet         string          `json:"cpuset,omitempty"`
  CPUSharedPools []CPUSharedPool `json:"cpuSharedPools,omitempty"`
}
CPUSet表示分配的 CPU。当 LSE/LSR Pod 请求时,koord-scheduler 将更新该字段。它是 Linux CPU 列表格式的字符串。更多详细信息,请参阅文档 。CPUSharedPools表示 LS Pod 使用的所需 CPU 共享池。如果节点的标签node.koordinator.sh/numa-topology-policy带有Restricted/SingleNUMANode,koord-scheduler 将为 LS Pod 找到最适合的 NUMA 节点,并更新需要 koordlet 使用指定CPU Shared Pool的字段。需要注意的是,调度器不会更新CPU Shared Pool中的 CPUSet 字段,koordlet 根据CPU Shared Pool中的Socket和Node字段绑定对应 NUMA 节点的CPU Shared Pool。
例子
具体例子:
apiVersion: v1
kind: Pod
metadata:
  annotations:
    scheduling.koordinator.sh/resource-spec: |-
      {
        "preferredCPUBindPolicy": "SpreadByPCPUs",
        "preferredCPUExclusivePolicy": "PCPULevel"
      }
    scheduling.koordinator.sh/resource-status: |-
      {
        "cpuset": "0-3"
      }
  name: test-pod
  namespace: default
spec:
  ...
节点 CPU 编排 API
从集群管理员的角度来看,需要提供一些 API 来控制节点的 CPU 编排行为。
CPU 绑定策略
标签 node.koordinator.sh/cpu-bind-policy 限制了调度时如何绑定 CPU、逻辑 CPU。
具体的取值定义:
None或空值不执行任何策略FullPCPUsOnly要求调度器必须分配完整的物理内核。等效于 kubelet CPU 管理器策略选项full-pcpus-only=true。SpreadByPCPUs要求调度器必须按照物理核维度均匀的分配CPU。
如果 Node 的 Label 中没有 node.koordinator.sh/cpu-bind-policy,则按照 Pod 或 koord-scheduler 配置的策略执行。
NUMA 分配策略
标签 node.koordinator.sh/numa-allocate-strategy 表示在调度时如何选择满意的 NUMA 节点。下面是具体的值定义:
MostAllocated表示从可用资源最少的 NUMA 节点分配。LeastAllocated表示从可用资源最多的 NUMA 节点分配。DistributeEvenly表示在 NUMA 节点上平均分配 CPU。
如果集群管理员没有在Node上设置标签 node.koordinator.sh/numa-allocate-strategy,但是 NodeResourceTopology 中的 kubelet.koordinator.sh/cpu-manager-policy 有选项 distribute-cpus-across-numa=true,然后按照 distribute-cpus-across-numa 的定义分配。
如果节点的标签中没有 node.koordinator.sh/numa-allocate-strategy 并且 NodeResourceTopology 中没有带有 Distribute-cpus-across-numa 选项的 kubelet.koordinator.sh/cpu-manager-policy,它将根据 koord-scheduler 配置的策略执行。
如果同时定义了 node.koordinator.sh/numa-allocate-strategy 和 kubelet.koordinator.sh/cpu-manager-policy,则首先使用 node.koordinator.sh/numa-allocate-strategy。
NUMA 拓扑对齐策略
标签 node.koordinator.sh/numa-topology-policy 表示如何根据 NUMA 拓扑对齐资源分配。策略语义遵循 K8s 社区。相当于 NodeResourceTopology 中的 TopologyPolicies 字段,拓扑策略 SingleNUMANodePodLevel 和 SingleNUMANodeContainerLevel 映射到 SingleNUMANode 策略。
None是默认策略,不执行任何拓扑对齐。BestEffort表示优先选择拓扑对齐的 NUMA Node,如果没有,则继续为 Pods 分配资源。Restricted表示每个 Pod 在 NUMA 节点上请求的资源是拓扑对齐的,如果不是,koord-scheduler 会在调度时跳过该节点。SingleNUMANode表示一个 Pod 请求的所有资源都必须在同一个 NUMA 节点上,如果不是,koord-scheduler 调度时会跳过该节点。
如果节点的 Label 中没有 node.koordinator.sh/numa-topology-policy,并且 NodeResourceTopology中的TopologyPolicies=None,则按照 koord-scheduler 配置的策略执行。
如果同时定义了 Node 中的 node.koordinator.sh/numa-topology-policy 和 NodeResourceTopology 中的 TopologyPolicies=None,则首先使用 node.koordinator.sh/numa-topology-policy。
例子
具体例子:
apiVersion: v1
kind: Node
metadata:
  labels:
    node.koordinator.sh/cpu-bind-policy: "FullPCPUsOnly"
    node.koordinator.sh/numa-topology-policy: "BestEffort"
    node.koordinator.sh/numa-allocate-strategy: "MostAllocated"
  name: node-0
spec:
  ...
节点资源拓扑 CRD
需要上报的节点资源信息主要包括以下几类:
- NUMA Topology,包括资源信息、CPU 信息如逻辑 CPU ID、物理 Core ID、NUMA Socket ID 和 NUMA Node ID 等。
- kubelet 配置的拓扑管理器范围和策略。
- kubelet 配置的 CPU 管理器策略和选项。
- 由 kubelet 或 koord-scheduler 分配的 Pod 绑定 CPU,包括 K8s Guaranteed Pod、Koordinator LSE/LSR Pod,但 LS/BE 除外。
- kubelet 定义的
CPU Shared Pool。
以上信息可以指导 koord-scheduler 更好地兼容 kubelet 的 CPU 管理逻辑,做出更合适的调度决策,帮助用户快速排查问题。
CRD 字段定义
我们使用 NodeResourceTopology CRD 来描述 NUMA 拓扑。社区定义的 NodeResourceTopology CRD 主要用于以下考虑:
- NodeResourceTopology 已经包含了基本的 NUMA 拓扑信息和 kubelet TopologyManager 的 Scope 和 Policies 信息。我们可以重用现有的代码。
- 跟上社区的发展,影响社区做出更多的改变。
兼容
koordlet 周期性的创建或者更新 NodeResourceTopology 实例。NodeResourceTopology 实例名与节点名保持一致。并通过添加标签 app.kubernetes.io/managed-by=Koordinator 描述节点由 Koordinator 管理。
扩展
目前 NodeResourceTopology 缺少一些信息,暂时以 annotation 或 label 的形式写在 NodeResourceTopology 中:
- Annotation
kubelet.koordinator.sh/cpu-manger-policy描述了 kubelet CPU 管理器策略和选项。方案定义如下
const (
  FullPCPUsOnlyOption            string = "full-pcpus-only"
  DistributeCPUsAcrossNUMAOption string = "distribute-cpus-across-numa"
)

type kubeletCPUManagerPolicy struct {
  Policy  string            `json:"policy,omitempty"`
  Options map[string]string `json:"options,omitempty"`
}
- Annotation
node.koordinator.sh/cpu-topology描述了详细的 CPU 拓扑。精细化的管理机制需要更详细的 CPU 拓扑信息。该方案定义如下:
type CPUTopology struct {
  Detail []CPUInfo `json:"detail,omitempty"`
}

type CPUInfo struct {
  ID     int32 `json:"id"`
  Core   int32 `json:"core"`
  Socket int32 `json:"socket"`
  Node   int32 `json:"node"`
}
- Annotation
node.koordinator.sh/pod-cpu-allocs描述了 Koordinator LSE/LSR 和 K8s Guaranteed Pods 分配的 CPU。Annotation Value 定义如下:
type PodCPUAlloc struct {
  Namespace        string    `json:"namespace,omitempty"`
  Name             string    `json:"name,omitempty"`
  UID              types.UID `json:"uid,omitempty"`
  CPUSet           string    `json:"cpuset,omitempty"`
  ManagedByKubelet bool      `json:"managedByKubelet,omitempty"`
}

type PodCPUAllocs []PodCPUAlloc
- Annotation
node.koordinator.sh/cpu-shared-pools描述了 Koordinator 定义的 CPU 共享池。共享池主要由 Koordinator LS Pods 或 K8s Burstable Pods 使用。该方案定义如下:
type NUMACPUSharedPools []CPUSharedPool

type CPUSharedPool struct {
  Socket int32  `json:"socket"`
  Node   int32  `json:"node"`
  CPUSet string `json:"cpuset,omitempty"`
}
CPUSet 字段是 Linux CPU 列表格式的字符串。更多详细信息,请参阅文档 。
创建/更新 NodeResourceTopology
- koordlet 负责创建/更新
NodeResourceTopology - 建议 koordlet 通过解析 CPU 状态检查点文件来获取现有 K8s Guaranteed Pod 的 CPU 分配信息。或者通过 kubelet 提供的 CRI 接口和 gRPC 获取这些信息。
- 当 koord-scheduler 分配 Pod 的 CPU 时,替换 kubelet 状态检查点文件中的 CPU。
- 建议 koordlet 从 kubeletConfiguration 获取 CPU 管理器策略和选项。
例子
完整的 NodeResourceTopology 示例:
apiVersion: topology.node.k8s.io/v1alpha1
kind: NodeResourceTopology
metadata:
  annotations:
    kubelet.koordinator.sh/cpu-manager-policy: |-
      {
        "policy": "static",
        "options": {
          "full-pcpus-only": "true",
          "distribute-cpus-across-numa": "true"
        }
      }
    node.koordinator.sh/cpu-topology: |-
          {
            "detail": [
              {
                "id": 0,
                "core": 0,
                "socket": 0,
                "node": 0
              },
              {
                "id": 1,
                "core": 1,
                "socket": 1,
                "node": 1
              }
            ]
          }
    node.koordinator.sh/cpu-shared-pools: |-
      [
        {
          "socket": 0,
          "node": 0,
          "cpuset": "0-3"
        }
      ]
    node.koordinator.sh/pod-cpu-allocs: |-
      [
        {
          "namespace": "default",
          "name": "static-guaranteed-pod",
          "uid": "32b14702-2efe-4be9-a9da-f3b779175846",
          "cpu": "4-8",
          "managedByKubelet": "true"
        }
      ]
  labels:
    app.kubernetes.io/managed-by: Koordinator
  name: node1
topologyPolicies: ["SingleNUMANodePodLevel"]
zones:
  - name: node-0
    type: Node
    resources:
      - name: cpu
        capacity: 20
        allocatable: 15
        available: 10
      - name: vendor/nic1
        capacity: 3
        allocatable: 3
        available: 3
  - name: node-1
    type: Node
    resources:
      - name: cpu
        capacity: 30
        allocatable: 25
        available: 15
      - name: vendor/nic2
        capacity: 6
        allocatable: 6
        available: 6
  - name: node-2
    type: Node
    resources:
      - name: cpu
        capacity: 30
        allocatable: 25
        available: 15
      - name: vendor/nic1
        capacity: 3
        allocatable: 3
        available: 3
  - name: node-3
    type: Node
    resources:
      - name: cpu
        capacity: 30
        allocatable: 25
        available: 15
      - name: vendor/nic1
        capacity: 3
        allocatable: 3
        available: 3